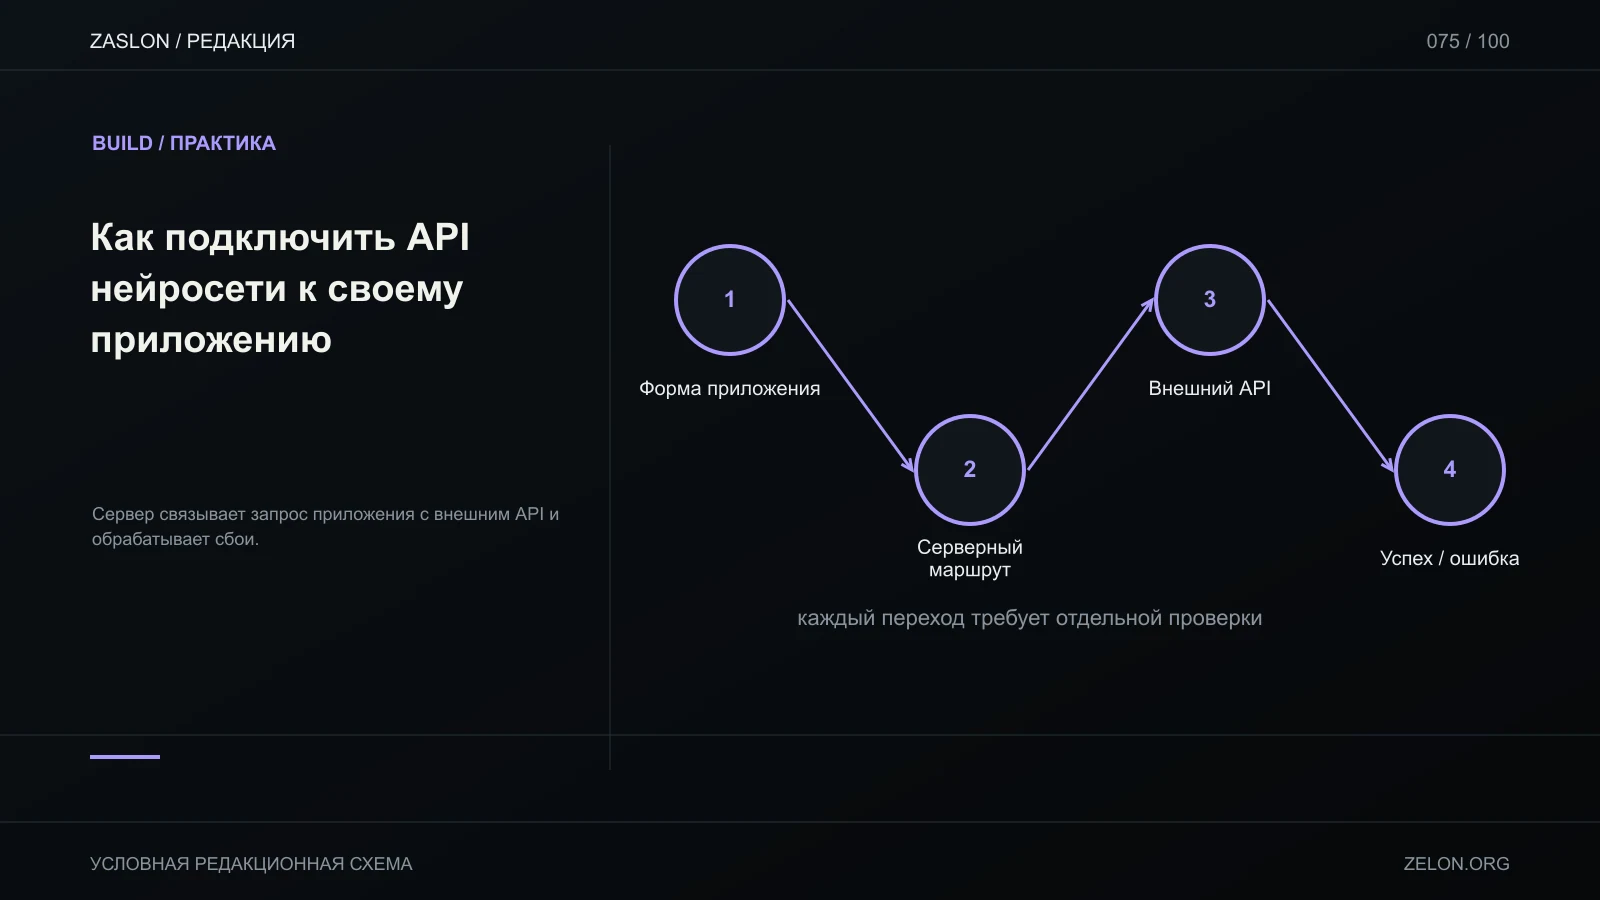
В примере редактор заявок предлагает сотруднику сократить длинное сообщение клиента до чернового резюме. Человек проверяет и редактирует результат; модель ничего не публикует и не отправляет клиенту автоматически. Такое ограничение превращает интеграцию в помощника внутри существующего процесса.
Проведи запрос через сервер
Маршрут: браузер отправляет текст вашему backend → backend проверяет пользователя, права и размер входа → сервер вызывает API → ограничивает и проверяет ответ → возвращает черновик сотруднику. Не вызывай провайдера напрямую из браузера: ключ, встроенный в клиентский код, доступен пользователю. OpenAI прямо требует хранить API key в секрете/переменной окружения на сервере и не публиковать в client-side code (API overview).
До разработки определи: какие поля отправляются, могут ли они содержать персональные сведения, какие ответы сохраняются, сколько времени, и кто имеет к ним доступ. Документация OpenAI о данных API описывает настройки хранения/использования для разных функций; проверяй актуальные условия конкретной конечной точки и аккаунта перед включением (Your data).
Ошибки — часть интерфейса
Не превращай любую ошибку в бесконечное «попробуйте снова».
| Ситуация | Что проверить | Поведение приложения |
|---|---|---|
400 |
формат, обязательные параметры и ограничения входа | показать исправимую ошибку, не повторять тот же запрос автоматически |
401 |
серверный ключ/права проекта | скрыть секрет и внутренний ответ; сообщить, что функция временно недоступна |
429 |
ограничение частоты или квоты | ограниченный backoff; если есть Retry-After, учитывать его; дать повторить позже |
временная ошибка 5xx |
доступность провайдера | ограниченное число повторов с задержкой и без двойного сохранения |
| billing/quota exhausted | состояние аккаунта и лимита | не делать автоматические повторы, отключить действие/сообщить оператору |
Официальный справочник OpenAI перечисляет типы ошибок и предлагает проверять статус и тело ответа (Error codes). Rate limits guide рекомендует экспоненциальную задержку с jitter для повторяемых ограничений и поясняет, что повтор без паузы не ускоряет доступ; платежные/квотные ошибки нужно разбирать отдельно (Rate limits). Повтор должен быть ограничен, иначе интерфейс сам увеличит нагрузку и расход.
Бюджет без выдуманной цены
Сначала поставь пределы на размер входа, число вызовов на пользователя, параллельность и максимальный ответ. Для текстовой модели оцени базовый бюджет так: запросов × [(входные токены на запрос ÷ 1 000 000 × цена входа за 1 млн токенов) + (выходные токены на запрос ÷ 1 000 000 × цена выхода за 1 млн токенов)]. Сверь единицу цены в актуальной карточке выбранной модели на официальной странице цен; формула не включает иные тарифицируемые функции, если они применяются. Добавь отдельно ожидаемые повторы и тестовые запросы. Тариф здесь не фиксируется.
OpenAI Production best practices советует оценивать расходы по предполагаемому трафику и устанавливать spending limits/alerts; фактическая сумма зависит от модели, объёма токенов и сценария (Production best practices). Ограничение расходов и уведомление полезны для контроля, но не заменяют серверное ограничение числа запросов.
Данные и приёмка
Не отправляй запросы, логи и API key в публичный клиент. В серверных логах оставляй request ID, тип ошибки и ограниченные технические метаданные; содержимое сообщения сохраняй только если оно необходимо и пользовательские правила это допускают. Покажи сотруднику источник и статус черновика, оставь возможность отказаться от результата.
Проверь: запрос без входа отклоняется; слишком длинный текст блокируется до вызова; ключ отсутствует в собранном JS; 401 не раскрывает конфигурацию; 429 замедляет повтор; исчерпанная квота не создаёт цикл; ошибка провайдера не стирает исходное сообщение. Для дублей сервер создаёт запись операции с уникальным request_id до вызова модели: повтор клиента с тем же ID получает существующий статус/результат, а не запускает параллельный вызов. Если соединение оборвалось после отправки модели, исход операции может быть неизвестен; не повторяй его автоматически, пока это не выяснено, иначе возможен второй платный вызов. Это критерии проверки, не отчёт о выполненных вызовах API.