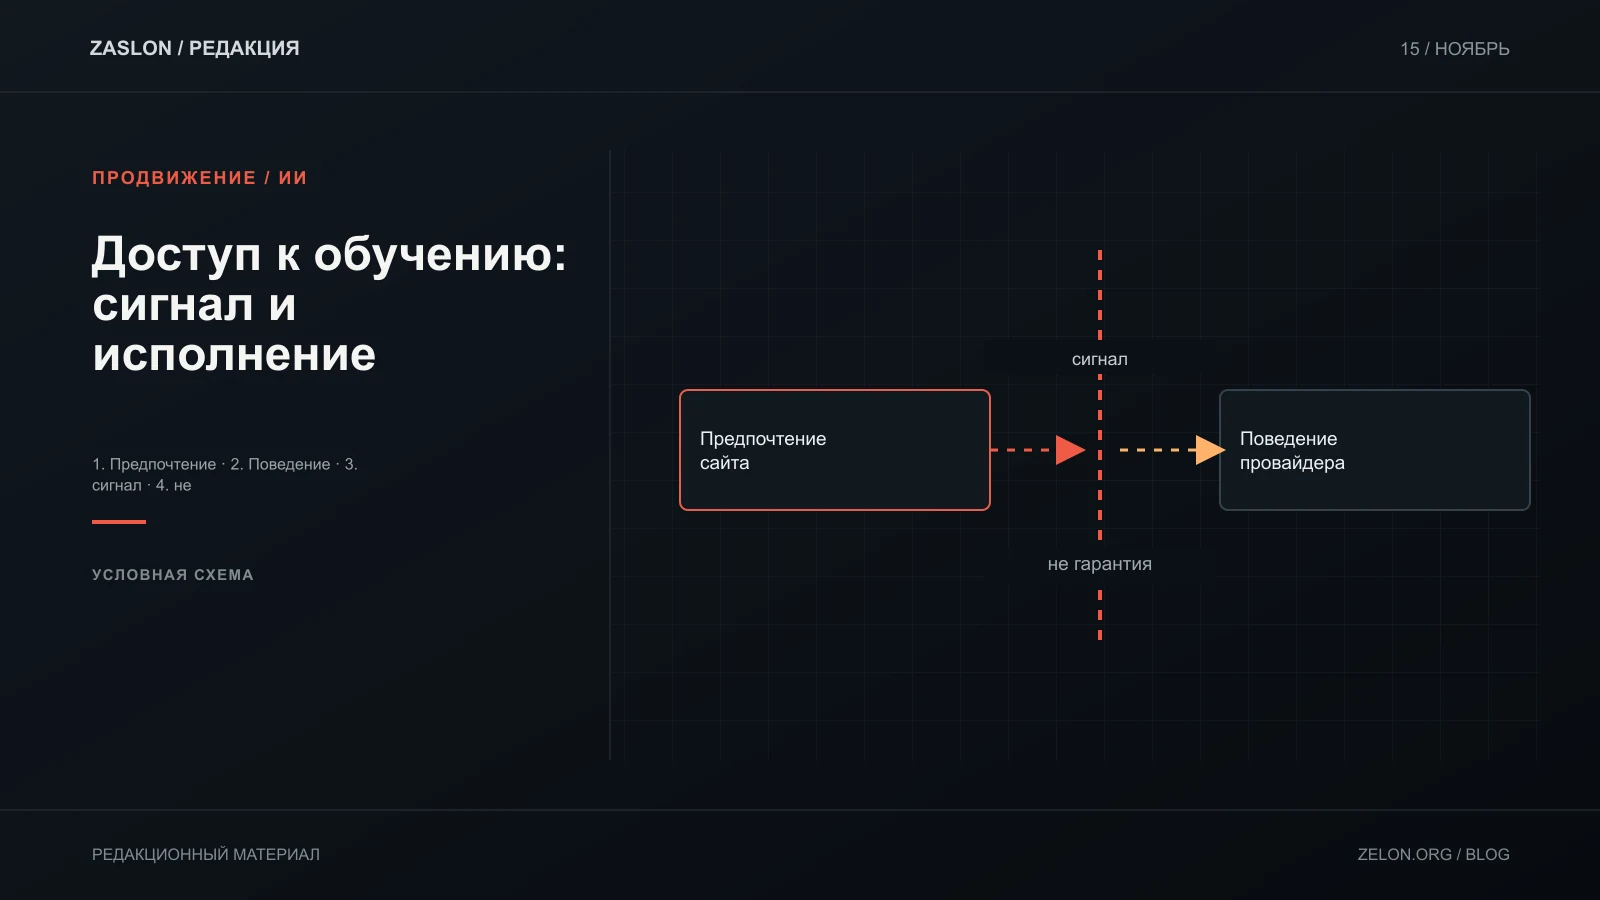
30 октября 2026 года Google и OpenAI сообщили о планах поддержать общий сигнал предпочтений по использованию веб-контента для обучения AI-моделей через robots.txt. Но это пока не готовая универсальная команда, которую можно включить и считать действующей у всех провайдеров: Google называет цель поддержки в 2027 году, а OpenAI пишет, что планирует внедрить сигнал в ближайшие месяцы и опубликует отдельное обновление о реализации (анонс Google, анонс OpenAI).
Это новость о совместимости, которая планируется, и отраслевом сигнале на основе работы группы IETF AIPREF. На дату проверки — 4 ноября — ни одна из этих страниц не объявляет о полном рабочем внедрении нового общего токена в crawler’ах этих компаний. Поэтому текущие правила robots.txt для отдельных роботов остаются важны.
Что обещают Google и OpenAI
| Компания | Что заявлено 30 октября | Срок в публикации | Что остаётся проверить |
|---|---|---|---|
| Планирует учитывать общий policy token в robots.txt; при определённых условиях это будет трактоваться как запрет Google-Extended | Планирует поддержку в 2027 году | Финальный синтаксис, точные условия и фактическое включение crawler’ом | |
| OpenAI | Говорит, что будет соблюдать общий сигнал и рассматривает его в рамках работы IETF | Внедрение ожидается «в ближайшие месяцы» | Конкретная дата релиза, точная интерпретация и доступность на production crawler |
Google отдельно подчёркивает, что существующие controls для конкретных компаний, включая Google-Extended, продолжат работать рядом с будущим общим механизмом. OpenAI говорит, что её текущие настройки crawler’ов также сохраняются. Следовательно, общий сигнал задумали как дополнительный слой управления, а не как отмену всех прежних правил.
Что можно сделать на сайте сейчас
Пока внедрение не подтверждено, не вставляй в robots.txt название токена, взятое из обсуждения или чернового предложения, если провайдер не опубликовал финальную инструкцию. Вместо этого сначала опиши собственную цель для каждой категории контента:
| Контент | Вопрос для команды | Проверяемое действие сегодня |
|---|---|---|
| Публичные страницы сайта | Разрешён ли обычный поисковый обход и индексирование? | Проверь доступность страниц и текущие правила Googlebot и других поисковых crawler’ов |
| Обучение моделей конкретного провайдера | Как этот провайдер документирует отказ или разрешение? | Используй действующий идентификатор и официальные правила конкретного crawler’а |
| Изображения и загружаемые файлы | Требуются ли отдельные правила доступа? | Проверь их URL, MIME и покрытие текущими правилами robots.txt |
| Закрытые материалы | Нужно ли исключить доступ из интернета полностью? | Используй аутентификацию и серверные права доступа, не полагайся на robots.txt как на защиту |
Robots.txt — это протокол для crawler’ов, которые добровольно соблюдают правила. Он не скрывает URL, не блокирует посетителя и не заменяет авторизацию. Если информация не должна быть общедоступной, закрой её сервером.
Как подготовиться к общему сигналу без преждевременного изменения
Создай список действующих директив и поясни, к какой цели относится каждая: поисковый crawl, использование контента для обучения, использование в ответах или доступ к изображениям. Эти цели не тождественны. Например, Google указывает, что Google-Extended управляет использованием контента для обучения будущих моделей Gemini и не влияет на включение сайта в обычную Search индексацию или на рейтинг.
Дальше веди короткий журнал изменений: дата публикации спецификации, точное имя токена, какие crawler’ы заявили поддержку, дата подтверждения в официальном changelog и результат теста на собственном robots.txt. Когда появится финальный формат, проверь его спецификацию, порядок приоритета общего и индивидуального правил, корректность синтаксиса и фактический ответ нужного crawler’а. Не считай одно наличие директивы доказательством, что каждый провайдер её прочитал.
Не смешивай отказ от обучения с запретом поиска
Важное следствие — общий сигнал нацелен на предпочтения по обучению AI-моделей. Это не автоматически команда скрыть страницу из Google Search, отключить генеративные ответы, запретить извлечение по запросу пользователя или закрыть сайт от всех автоматических систем. Конкретные цели и действие каждого токена нужно проверять в опубликованной спецификации.
Для Google уже есть отдельное руководство Google-Extended; его область действия отличается от поискового Googlebot. Для OpenAI опубликованы собственные crawler controls. Эти существующие правила — предмет текущей настройки; новость об общем сигнале описывает будущую совместимость, сроки которой компании формулируют по-разному.
Если сайт использует отдельные правила для SEO, AI training и закрытых данных, держи их в разных разделах конфигурации и документируй причину. Это упростит будущую миграцию и позволит не закрыть случайно поиск, когда цель — только выразить предпочтение по обучению. Повторно проверь официальные источники перед изменением: сроки «в ближайшие месяцы» и «в 2027 году» не дают точной даты запуска.