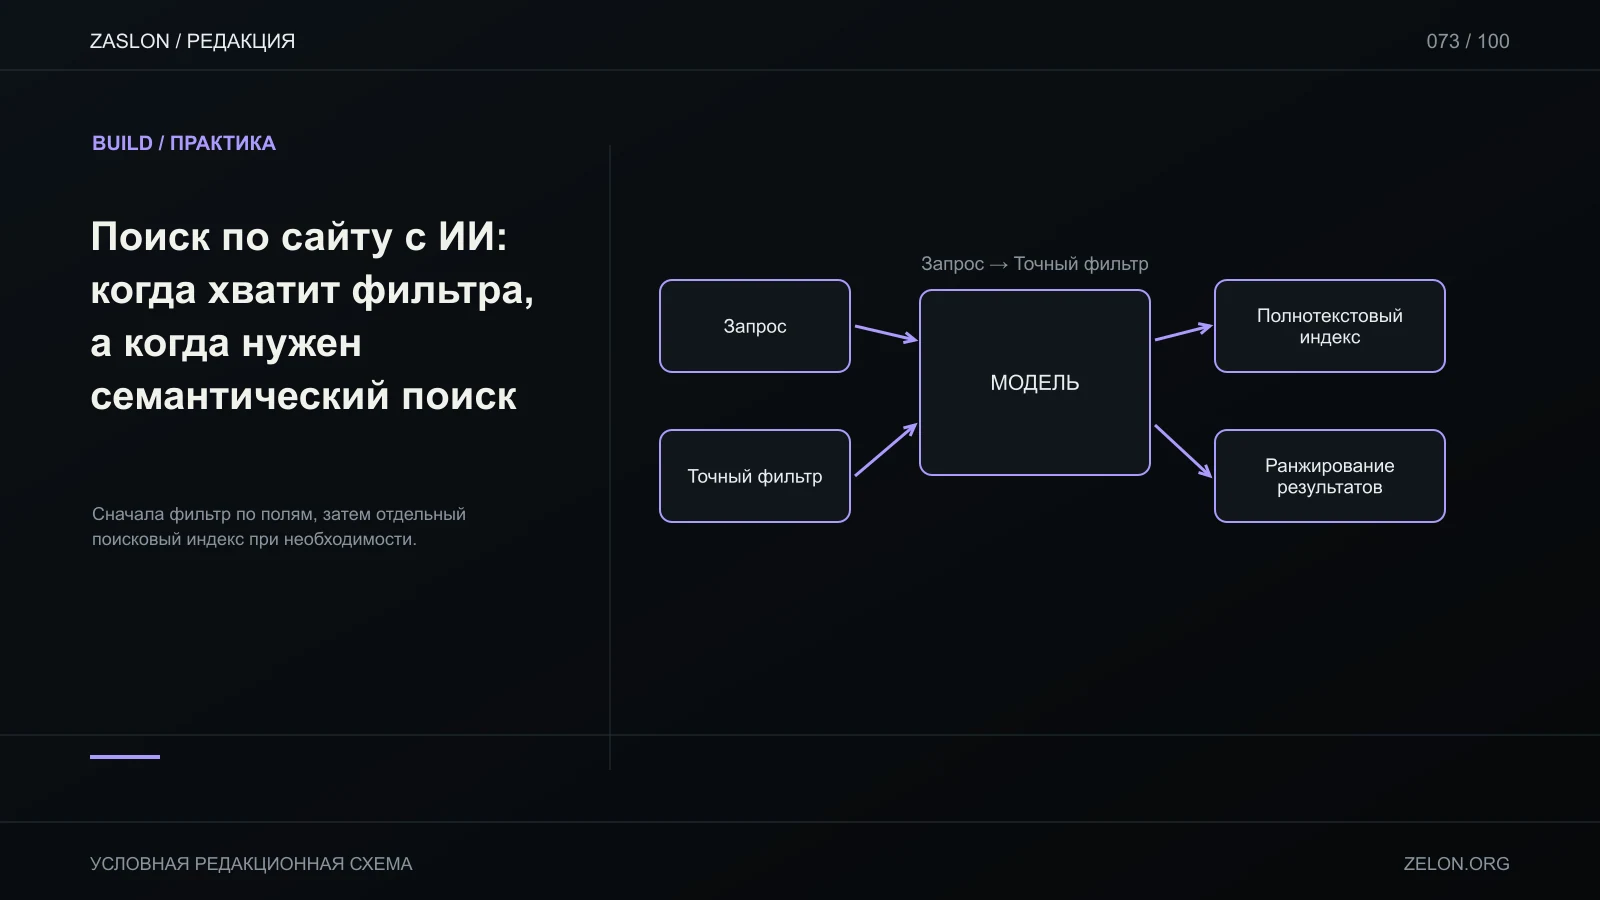
В каталоге городских мастер-классов ищут по дате, району, возрасту, названию и смыслу описания. Один поисковый механизм не одинаково хорошо решает все эти задачи. Сначала раздели точные ограничения и приблизительное совпадение по словам или значению.
Три запроса к одному каталогу
У карточки есть поля: title, description, district, date, age_min, age_max, tags, status. Рассмотрим запрос «гончарная мастерская рядом в выходные для ребёнка 10 лет».
| Тип | Что ищет | Применение в каталоге | Типичная ошибка |
|---|---|---|---|
| Фильтр | точное условие по отдельному полю | ближайшая суббота/воскресенье, район, диапазон возраста 10 | свободный текст не превращается автоматически в фильтры |
| Полнотекстовый | слова и лексические формы в индексируемых текстовых полях | «гончарная мастерская», имя ведущего | синоним «лепка из глины» может не совпасть с этими словами |
| Семантический | сходство смысла запроса и описания | «занятие, где из глины делают чашку» | похожесть не доказывает наличие места, подходящую дату или точный возраст |
Сначала извлеки явные условия и примени их к структурированным данным. Затем полнотекстовый или семантический поиск ранжирует кандидатов в оставшейся выборке. Если не можешь надёжно извлечь «в выходные» или возраст, попроси уточнение вместо того, чтобы молча расширить выборку.
Полнотекстовый поиск
В PostgreSQL текстовый поиск обычно преобразует документ и запрос в нормализованные токены, затем сопоставляет их. Supabase показывает использование to_tsvector, to_tsquery и оператора @@; язык конфигурации влияет на разбор слов и стемминг (Supabase full-text search). В собственном каталоге выбирай поля и конфигурацию языка осознанно. Официальная документация PostgreSQL описывает конфигурации, словари, ранжирование и индексы текстового поиска (Text Search).
Для русского каталога проверь формы слов, транслитерацию, опечатки и имена. Не объявляй «поиск по смыслу», если выполняется только совпадение токенов. И не включай в индекс закрытые внутренние заметки, если их не должны видеть посетители.
Семантическая выдача и источники
Семантический поиск кодирует текстовые фрагменты и запрос в embeddings и ищет близкие векторы. OpenAI описывает retrieval как поиск по смысловой близости; результат содержит подходящие фрагменты, оценки сходства и источник документа (Retrieval guide, Embeddings guide). Эти оценки пригодны для ранжирования, но не являются вероятностью правильности или гарантией актуальности.
Для каталога сохраняй в выдаче ссылку на исходную карточку. Перед показом проверь её текущий статус и дату: старый embedding не должен вернуть отменённое мероприятие. Возраст, дату и район всё равно перепроверь точным фильтром. Если модель формирует объяснение, оно должно ссылаться на действующую карточку, а не представлять похожий текст как факт.
Набор проверок перед запуском
Составь небольшой ручной набор запросов с ожидаемыми карточками: точный район и дата; название с опечаткой; синоним в описании; событие для ребёнка ровно 10 лет; отменённая карточка; пустой запрос; запрос без результатов. Для каждого запиши допустимое первое место, карточки, которые обязаны исключаться, и что делать при низкой релевантности. Отдельно проверь, что выбранные фильтры видны и могут быть сняты.
Начни с простого фильтра и полнотекстового поиска, если люди ищут по полям/названиям. Добавляй семантическое ранжирование только если реальные примеры запросов показывают проблему с формулировками; измеряй долю ожидаемых карточек в первых результатах и ложные совпадения на своём размеченном наборе. Это план проверки, не утверждение о результатах тестирования.