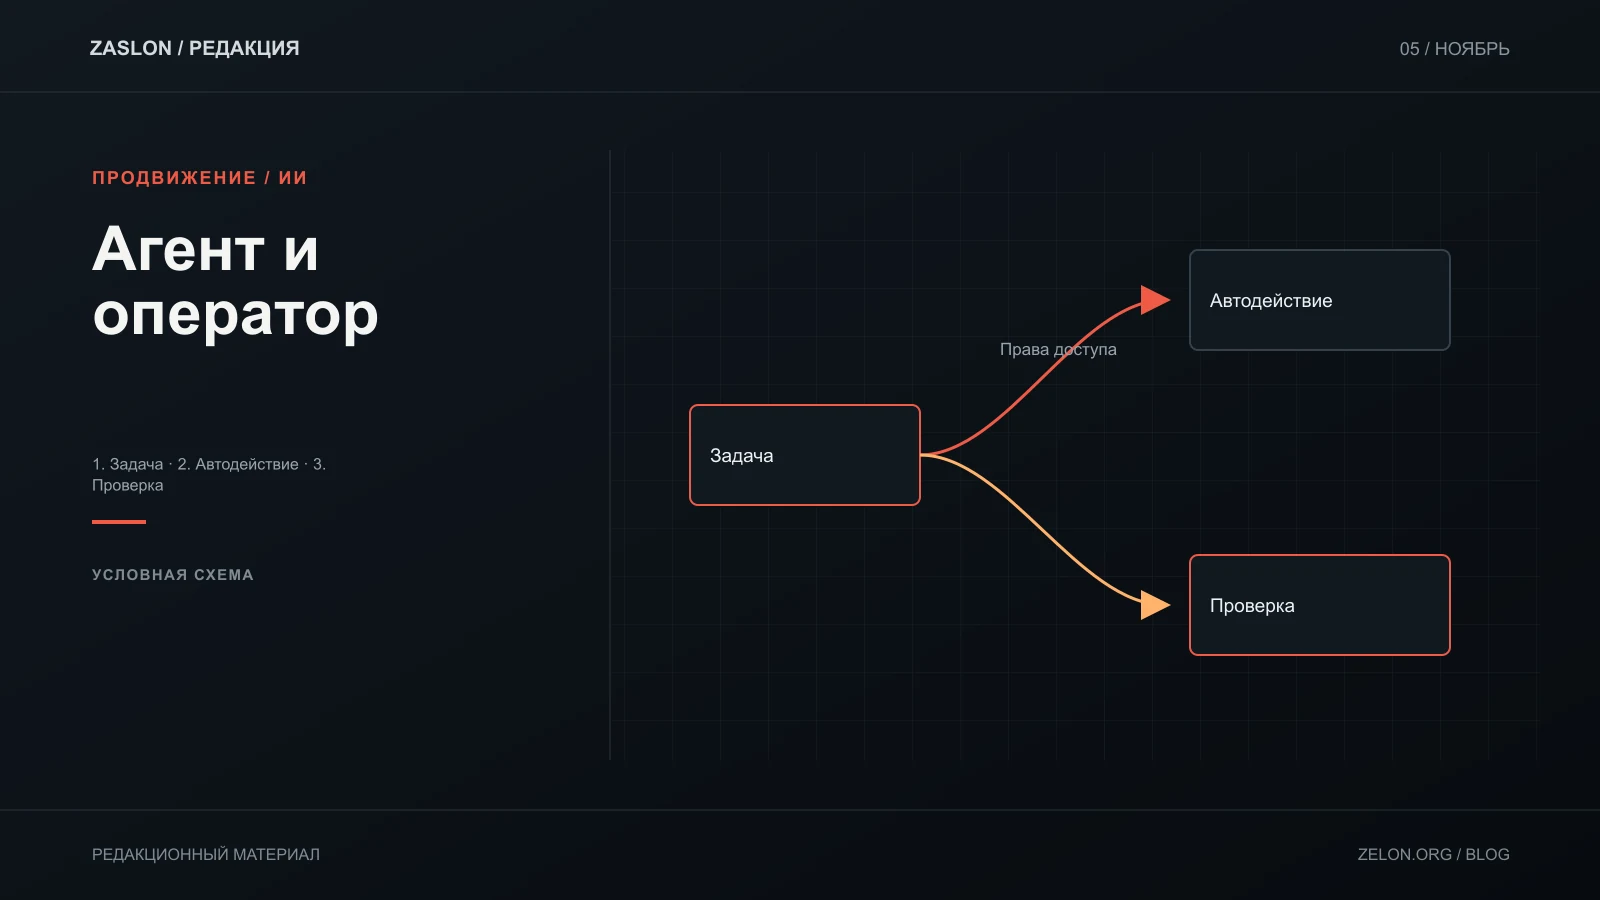
13 ноября 2026 года OpenAI опубликовала историю Shield, поставщика IT-услуг, чья платформа Forge использует GPT‑6 Astra для поддерживаемых browser-задач в legacy-порталах. По описанию кейса, техники задают, какие действия агент может выполнять самостоятельно, а какие требуют проверки или одобрения. Shield сообщает о тысячах запусков в месяц и среднем ускорении на 35–40% по сравнению с прежними моделями для computer-use задач. Это утверждения в customer story OpenAI; опубликованная страница не раскрывает полную методику сравнения и не даёт независимой оценки. Кейс Shield.
Кейс не означает, что агент умеет работать в любом старом портале или заменяет техника. OpenAI отдельно указывает, что часть задач — в том числе звонки, выезды и remote desktop work — по-прежнему требует людей. Эти сведения относятся к Shield и её рабочей среде.
Предлагаемый пилот для своей команды
Следующий протокол — наша редакционная рекомендация, а не внутренняя методика Shield.
Предположим, поддержка получает тикет «сбросить доступ» в тестовом портале. До пилота команда задаёт:
- Разрешённое действие: агент может открыть тестовую карточку и подготовить сброс, но не отправлять финальное действие.
- Точка подтверждения: оператор сверяет пользователя и нажимает подтверждение сам.
- Критерий результата: карточка показывает новый статус, а в журнале остаются исходная запись и итог.
- Остановка: неожиданный экран, несовпадение идентификатора или дополнительное разрешение прерывают выполнение и передают тикет человеку.
- Сравнение: на одинаковых тестовых задачах записывают время, неверные изменения, эскалации и ручные исправления.
Если агент ускорился, но создаёт больше исправлений, одна метрика времени не делает пилот успешным. Если в кейсе другого поставщика сказано «тысячи запусков» или «быстрее на X%», это не переносится на твою систему без одинаковой задачи, baseline и проверки ошибок.
Как интерпретировать историю
Из материала можно вынести ограниченный вывод: компьютерное управление интерфейсом рассматривается Shield для некоторых поддерживаемых действий, а политики разрешений и проверок задают техники. Нельзя вывести из этого универсальную точность, безопасность или экономию. Предложенный выше пилот — конкретный способ сформулировать собственные условия теста, не приписывая его OpenAI или Shield.
Для подготовки такого пилота пригодится план тестирования ИИ-агента на заданиях, ошибках и стоимости выполнения.